An English version is not yet available. The original Chinese text appears below.
刚刚,DeepSeek 没有发模型。
产品部与 Harness 团队发了一篇长篇架构文章,《Super-agent 设计探索:迈向更自主的 Agent 系统》。
科技媒体抓的是能力:AI 能在群里没人 @ 的时候自己发现 Bug、提交修复 PR,能跨 IM 和 GitHub 把一个任务连续推进,能 24 小时在线。
这些当然重要。但这份文章递到一位书记或校长手里,真正该划线的是它顺手回答的一个组织问题:当执行不再是瓶颈,组织该怎么重新分工。
文章里有一句话,夹在两段技术论证中间,写得很轻:
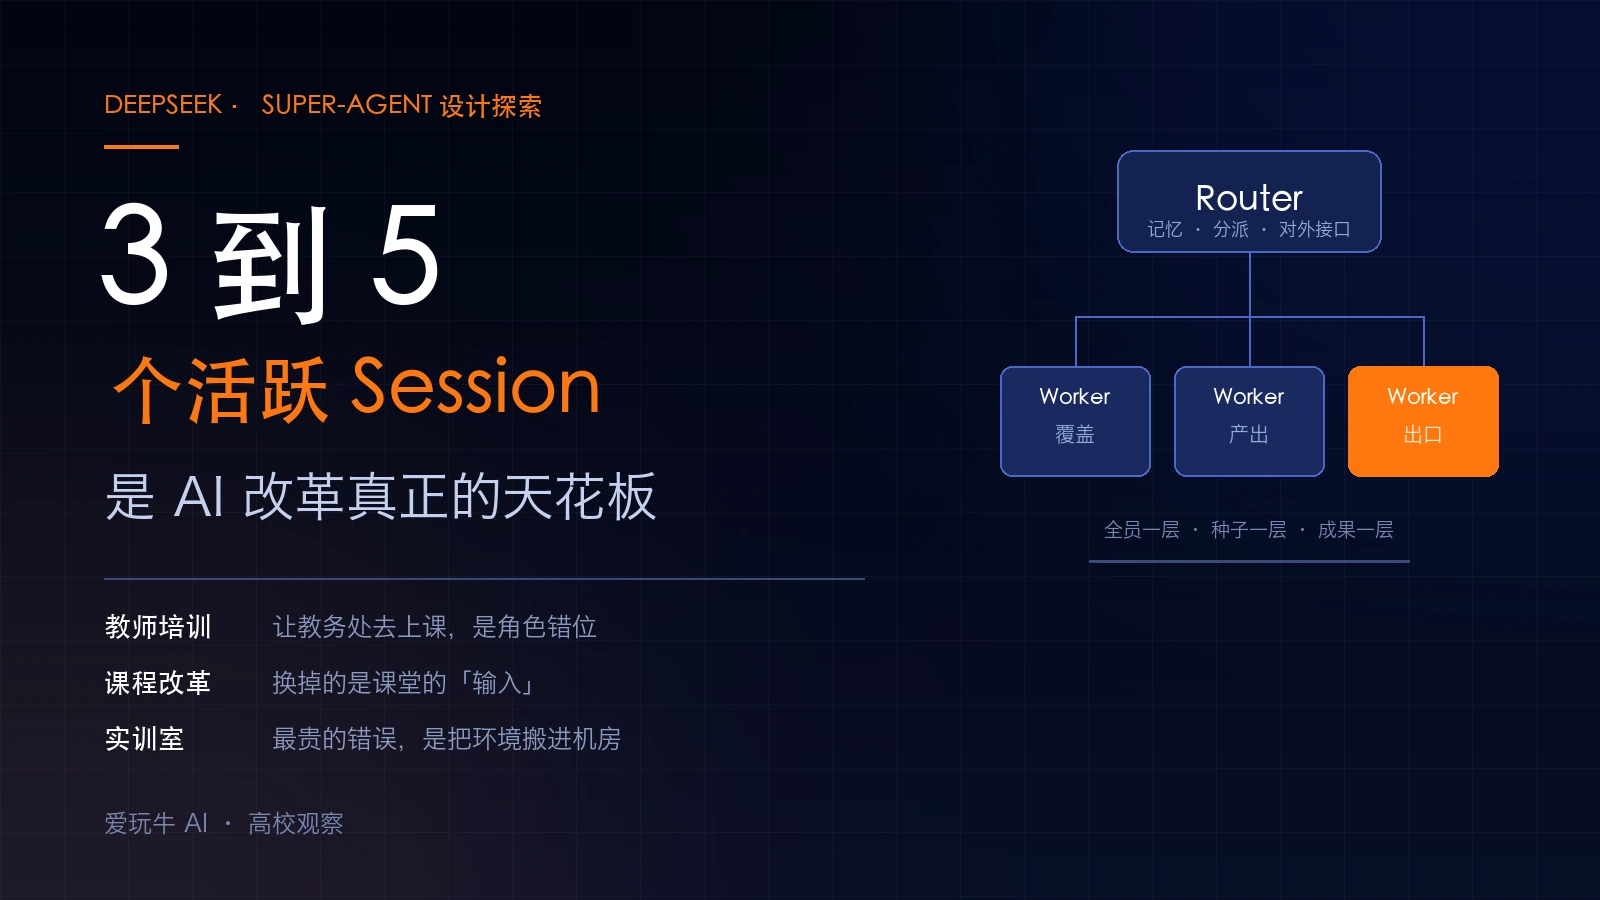
一个人通常只能同时跟进 3 到 5 个活跃 Session。
这不是产品观察,是一道天花板。
它同样精确地描述了今天的高校。一位教师一学期带四门课、两百个学生,外加科研、评估和几张表格。他的「并发数」就这么多。所有关于 AI 改革的雄心,最后都在这条线下面排队。
真正跟进的「活跃会话」
的长期机时利用率
实训室,常被分开报预算
过去两年,高校应对这条线的方式高度一致:用采购的方式,解决能力的问题。
于是有了三个反复出现的场面。
智算平台建起来了,机时利用率长期不到三成
设备科的台账很漂亮,教务处的课表上找不到几门课真在用。
AI 通识课开起来了,翻开大纲还是 Python 语法
加几个演示案例。学生上完一学期,会跑 demo,不会用。
实训室验收那天来了两拨人参观,之后门是锁着的
揭牌、拍照、发通稿。钥匙在实验中心。
三件事,其实是同一个动作的三个变体:
加了一个东西,没有改结构。
这篇文通篇都在讲「改结构」。它不谈怎么往系统里塞更多东西,谈的是重新划清谁负责什么、什么该固化成代码、什么该留给判断、什么必须留在原地。
这套思路,正好能拆成那三件事的施工图。
PART 01政策给的是一条链,不是三张任务单
先把政策摆清楚,它比任何动员讲话都硬。
2026 年 4 月,教育部、国家发展改革委、工业和信息化部、科技部、国家数据局联合印发《「人工智能+教育」行动计划》,提出到 2030 年基本形成人工智能与教育深度融合的发展格局。
被引用最多的是几句话,但引用的人常常把它们当成并列任务:
| 政策原文要求 | 它在链上的位置 |
|---|---|
| 公共基础课 | 推动人工智能成为高校公共基础课,面向全体学生 → 这是「课程要求」 |
| 分类教材 | 按学科专业分类编写课程教材,打造「短实新」前沿课程 → 这是「教材要求」 |
| 素养标准 | 制定教师智能素养标准,分层分类培训、实现全覆盖 → 这是「谁来教」 |
| 资格考试 | 将人工智能纳入教师资格考试和认证内容 → 这是「教师怎么达标」 |
| 成果认定 | 教学成果奖设「智能教育」项目、纳入「双千」计划 → 这是「达标了怎么被承认」 |
注意它们的排列。这五个不是并列任务,是一条链:
链上任何一环单点突破,都会漏。
而大多数学校的操作顺序是反的:先把课开出来,因为课表最容易改。开完发现没人能上,于是请企业来讲几场,或者整个压在计算机学院。第二年评估,通识课变成「外聘讲座+线上视频」的拼盘,学分照给,能力没长。
这不是执行不力,是顺序错了。
正确的顺序是:
先把教师这一环打通。没有人能上,课开得再整齐也是空的。
有了人,才谈得上按学科分类编教材、做「短实新」的前沿课程。
最后才是实训室。它是环境,不是起点。
下面逐条说。每一条,都能在这篇文章里找到对应的设计。
PART 02教师培训:让教务处去上课,是角色错位
文章里最容易被跳过的一段,是双层架构。
要同时做到「连续」和「高效」,系统必须在会话组织上做取舍:所有事件交给同一个会话,上下文最连续,但会串行阻塞;每条事件都新开会话,吞吐最高,但上下文割裂、回复混乱。
DeepSeek 把这两件事拆到两层。
只负责承接交互、维护全局记忆、分派任务
它不执行具体任务,甚至可以不配备执行工具。
上下文彼此隔离,挂着完整工具
专注把一件事做完,不直接对用户说话。
文章里有一句设计说明:
DeepSeek 原文Router 的价值不在执行,
在于它是全局的序点、协调点和记忆。翻译成学校语言:教务处和教师发展中心是 Router,二级学院的骨干教师是 Worker。
现在回头看绝大多数高校的教师 AI 培训。请两位专家讲一天半,签到,发学时证明,结束。
这不叫培训,叫告知。
问题不在专家讲得好不好,在于角色错位:我们让 Router 去当了 Worker,让最该做统筹、分派和记忆的部门,去做它最不擅长、也最不该亲自做的事。
Router 该干的活,文章里写了三件。
一、全局记忆
Router 存在的意义,是所有跨任务的信息与决策都在这里汇总。对应到学校,是一份全校可查的改造档案:哪个学院、哪门课、改到哪一步、卡在哪、谁在做。没有这份档案,一所万人大学每年都在重新发现同一个问题。
二、分派
Router 只处理任务之间的高层关联,不介入单任务内部。对应到学校,是选拔种子教师、配对双师、把任务派到具体的人头上,而不是发份通知等学院自己报。
三、对外接口
Worker 不直接对外,由 Router 统一回复。对应到学校,是所有口径、成果、申报材料从一个口子出。否则各学院各说一套,评估时对不上。
有两个样本值得看。它们的共同点不是花钱多,是把 Router 建起来了。
| 学校 | 做法 |
|---|---|
| 四川大学 | 「四阶十维」教师人工智能素养框架,配两年行动计划。2026 年「启航计划」全员通识年,各学院组织全体教师以必修加选修完成专题培训;2027 年「领航计划」分层深化年,转向中青年教师的教学应用实操。硬指标:每个学院孵化「AI+课程」优秀案例 5 到 10 个,选育「AI 教学先锋教师」约 30 人。 |
| 合肥经济学院 | 专项投入 1000 余万元教师数智化经费,构建「顶尖高校研修+头部企业实训」双轨体系,分批送千余名教职工赴浙江大学、同济大学、上海交通大学研修;同时常态化派青年教师进企业,做 AI 赋能、算力应用、智能体开发的培训与行业认证。回校后还要过三道工序:教研分享、课堂转化、项目孵化。 |
两校的共同结构是三层:全员一层负责覆盖,种子一层负责产出,成果一层负责出口。这正是文件要的「分层分类+全覆盖+测评」。
还有一条制度设计值得单独拎出来。
文章讲事件路由时给了一组数据:取消「直通」机制后,Router 需要做的决定增加了约 30%,总读缓存 token 从 2323 万涨到 3177 万,增幅约 37%。
所以「直通」在学校里对应什么?授权加备案。
种子教师的课程改造方案,教务处备案即可开工,不必排队等三轮论证。Router 保留观测权,不做每件事的审批人。这条不写进制度,前面所有分层都会退化成层层请示。
PART 03课程改革:换掉的是课堂的「输入」
文章第三节讲「事件驱动」,起点是个很朴素的变化:Agent 的主要输入,不再是人类逐条键入的提示词,而是环境里持续产生的半结构化事件——群消息、邮件、代码评审评论、CI 结果。
这个转变对课程的启发,比任何教学法名词都直接。
| 课堂输入 | 长什么样 |
|---|---|
| 教案(昨天) | 预定义、线性、可穷举、有标准答案。教师把知识点排成 32 个学时,按顺序投放。 |
| 事件(今天) | 一个模糊的需求、一份脏数据、一条自相矛盾的评论、一次失败的运行。有噪音、有歧义、需要现场判断。 |
用教案训练出来的学生,到了事件现场会失能。这才是「会跑 demo,不会用」的机制性原因。
这篇文章里有三样东西可以直接借。
两级过滤:什么该固化成肌肉记忆,什么该留给现场判断
面对海量事件,DeepSeek 没让大模型逐条判断,延迟和成本都受不了。它做了 Fast Path / Slow Path:确定性条件用代码快速筛掉,剩下真正需要理解的才交给模型。
这是一条极好的课程分层判据。必须固化成肌肉记忆的基本功——统计口径、编程规范、实验安全、学术引注——不需要每次现场判断,练到条件反射就行。必须现场判断的东西——这个场景该不该用 AI、这个输出可不可信、这个方案值不值得做——才需要占课堂时间。
现实中的 AI 课程,两类错误各占一半。全当 Slow Path 教,每节课都在讨论「AI 的伦理与未来」,学生四年下来手上没有硬功夫;全当 Fast Path 教,AI 课上成 Python 语法课和工具说明书,学生一进真实场景就废。
分层的意义在于承认:这两类需要完全不同的教法、课时和考核方式。
把上下文当预算:学时就是学生的上下文预算
文章里有一句话,整个 AI 教育最该抄进教务管理规定:
浪费上下文窗口,就是浪费模型的智能。
窗口有限。注入太多,挤占空间、稀释注意力;注入太少,模型得反复调工具去读,步数暴涨。所以 DeepSeek 把上下文当 Cache 经营:能预判要用的直接内联,超预算的留在窗口外、只留引用和摘要。
一门 32 学时的课,塞进 40 个知识点、8 个工具、3 个大作业,看上去充实,实际是把窗口塞满、把注意力稀释。学生记住的是碎片,不是结构。
敢不敢做减法,是这一轮课程改革最见功力也最不讨好的一件事。减法在大纲上不好看,在评估表上不加分。
承认试错:把「尝试过但不成立」也算作学习证据
文章里还有个设计:Agent 在还不确定结果是否被采用时,就根据环境信号在后台先试一把。结果有价值就交付,没有价值就丢弃。
这是对「试错」的工程化承认。对应到课堂是三个安排:允许失败的实验课,过程性评价占足够权重,把「尝试过但方案不成立」也算作有效学习证据。
如果一门课的评分里只有正确答案得分、错误答案扣分,学生就会本能地绕开所有不确定性。而那恰恰是 AI 最不值钱的部分。
已经跑到前面的学校,路径已经很清楚了
| 学校 | 路径 |
|---|---|
| 哈尔滨 职业技术大学 | 以课程改革牵引教师学习。启动「AI+课程改革」专项,让全校各专业和公共基础课教师围绕本领域的 AI 应用做教学创新——教师为了上课,必须自己先学。再组跨学科团队集体攻关,为全校各年级开人工智能通识与应用公共必修课,教师在这个过程中从「技术学习者」变成「课程开发者」,最后凝练成教材。配套以赛促用:首届 AI 赋能教学能力比赛 192 位教师参加初赛,27 位进校赛,评出 16 项优秀作品。 |
| 武汉大学 | 把通识课做成全校统一底座:一门《人工智能导引》面向全体学生,配多学科垂域的通关实验室。 |
关于教材,「短实新」三个字是一句授权:
不必等统编教材,允许讲义先行、活页迭代、一年一版。
AI 领域的统编教材出版即滞后。等书到了,技术已经换了一代。
敢不敢用自己的讲义上课,是这一轮课程改革的分水岭。
PART 04实训室:最贵的错误,是把环境搬进机房
这是三件事里花钱最多、最容易走偏的一项。
文章第五节讲了一个很具体的工程难题:Agent 的计算要放到云端才能持久在线,但执行环境搬不走。
为什么搬不走?原文列得实在:真实开发环境里有未提交的本地修改、私有凭据、内网服务依赖、特定硬件和工具链。在云端重建一套,成本极高还容易漏。
DeepSeek 的解法是解耦:计算在云端跑,环境留在原地,端侧只放一个不保存会话状态的轻量 daemon,负责执行命令、返回结果。这个设计有个名字,叫 BYOM(Bring Your Own Machine)。
把这条平移到高校,很多学校正在犯的错误就露出来了:
我们在把环境搬进机房。
每个学院建一个 AI 实验室,每个实验室配一批 GPU 和几十台工作站,每台机器装一套环境,每个环境各配一个厂商账号。设备总量上去了,利用率下来了,维护成本指数级上升,跨学院的课排不进去,三年后设备过时全部重来。
国家对这件事的态度,文件里写得很清楚:基础环境要「强调集中建设,避免低效重复投入」,由国家牵头建教育智算服务平台、教育科研基础语料库和教育专用大模型,为各级各类学校提供算力、数据、模型和工具。
国家层面在收口,学校层面就不该再铺摊子。
校级该怎么建?三句话。
一个底座,N 个接入点
算力、模型、平台集中建一套,全校共用;真实业务环境分散留在原地,通过接口接进来。
长江师范学院与美林数据共建的「人工智能通识+专业教学一体化实验室」就是这个结构:一个底座、双重支撑、分层教学、资源共享。同一个平台既承担全校各专业的 AI 通识教学,也承担 AI 专业的算法与工程训练。美术类学生用它做创意设计,人文类学生用它做资料处理,共用一套算力和数据源,各自独立成课。
这个结构的价值不在省钱,在于它让非计算机专业的学生真的用得上。
把「训模型」换成「编排智能体」
上一代实训室的核心任务是训模型:调参、跑 benchmark、看准确率,比的是显卡数量。
这一代的核心任务正在变成搭智能体:把大模型、知识库、业务系统、工具调用串起来,让它在真实流程里跑通一件事。教学形态更接近软件工程和系统集成,需要的是流程、接口、权限、评测、异常恢复。
这里有个很有意思的巧合:DeepSeek 这篇文章本身,就是一份现成的教学案例。
这五个问题,是任何一个做智能体的人都必须回答的。现在有一份公开的、写得很细的标准答案。把它们搬进课堂,比再买一批设备有用。
| 形态参考 | 做法 |
|---|---|
| 合肥经济学院 | 国产化算力中心:32 张昇腾 910B4 加速卡,FP16 总算力约 9 PFLOPS,支撑 AI 通识、AIGC 实训、大模型轻量化训练、智能体开发,同时面向区域高校和中小微企业免费开放。 |
| 山东外国语 职业技术大学 | 更轻的形态:与华为共建人工智能实践实验室样板点,配全国首个与华为合作的 AI 通识一体机,可同时满足 200 名学生同步实践。 |
这两所值得注意的不是设备规模,是它们都把实训室接进了课程表和专业建设,没有让它单独存在。
招标之前,先写清三个使用率
课程使用率:每学期多少门课、多少课时在这里上。要写具体课程名和学时,不能写「预计覆盖全校」。
非计算机专业使用率:如果 90% 的使用者都来自计算机学院,这个实训室对「全校 AI 素养」的意义有限,本质是个专业实验室。
对外开放服务时长:面向区域院校、企业、中小学的服务量。这条直接决定它能不能拿到后续的政策和资金支持。
三个使用率写不进方案,就先别急着招标。
反过来,如果验收标准是「设备清单与合同一致」,这个实训室大概率会变成参观路线上的一个点。
PART 05教学督导:系统在跑,不等于任务在推进
文章第六节讲 Watchdog,一个独立于主系统之外的控制回路。它有一句诊断,对高校教学监控体系的针对性极强:
原文仅靠传统的进程存活探测或监控脚本是不够的
因为许多异常并非进程崩溃,而是模型在执行中陷入无效循环或偏离目标。
系统还在跑,不等于任务在推进。
我们的督导体系,很大程度上就是一套进程存活探测:查课表是否执行、进度是否吻合、材料是否齐全、课堂是否有序。这些指标能发现「停摆」,发现不了「空转」。
而这一轮 AI 进课堂最容易出现的恰恰是空转:PPT 里加了 AI 元素,课堂上有一次大模型演示,作业允许用 AI 完成,评估材料里写「已实现 AI 赋能」。看起来全在跑,实际没有一件事在推进。
所以督导指标必须改。建议只改一条,但改到位:
从「这门课是否使用了 AI 工具」,改为「这门课的学生是否产出了可验证的作品」。
可验证的意思是:能跑、能用、能被第三方复现、能说明它是怎么做出来的。这一条能同时挡住教师的表演式 AI 教学和学生的 AI 代写。
PART 06这篇文章自己承认没解决的事
给决策者写东西,只讲成功案例是不可信的。这篇文章有个难得的品质:最后专门列了开放问题。
实验是简化的
作者自己写明:实验基于合成负载与简化环境,部分设置还可以更严谨,「以上结果仅作为初步参考」。那组 12.4 分钟对 29.5 分钟的数据是方向性信号,不是成绩单。
现在市面上几乎所有「AI+教育」方案都处在这个阶段。别被 demo 说服,要自己跑一遍。
安全与隐私是真风险
文章说得很直接:云端 Agent 一旦被攻破,它连接的全部端侧设备都面临被控制的风险;即使云端没事,只要端侧凭据能进入模型上下文,正常执行过程中同样存在凭据泄露风险。
对应到高校,就是学生数据、科研数据、校内业务系统的权限边界。
跨边界协同没有标准答案
一个组织内存在多个彼此隔离的实例时,如何安全可靠地通信协作仍需探索。
对应到高校,是跨院系的课程共享、跨校的学分互认,以及最难的——一个学生四年的成长数据怎么在学院之间流转而不失控。
政策也明确要求「强化人工智能进校园管理,明确智能产品、终端的应用规范」,防范「学术造假、泄露隐私」。这条不能等出了事再补制度。
采购技术方案时就写进合同:数据不出校、凭据不进上下文、日志可审计。
这三条不是劝退,是提醒:这一轮建设,方案要留出修改的余地。把架构做成可替换的,比把功能做全更重要。
PART 07给决策者的三个动作
如果这篇文章只留下一句话,我希望是这句:
这三件事的预算,不要分三条线报。
分三条线报的结果,是被切成三个小项目,各自都不够用,各自都做不成:教师培训做成两天讲座,课程建设做成一本讲义,实训室做成一批设备。
打包成一个「AI 教学能力建设专项」,一把手挂帅,教务处、人事处、信息中心、二级学院联合推进,才有做成的可能。
- 第 1–2 周
成立跨部门工作组,明确牵头人。必须有签字权,不能是联络组。同时指定「谁负责全局记忆」——它不该是新增一个办公室,而是在现有部门里明确一份档案的归属。
- 第 3–4 周
做一次教师 AI 素养基线摸底。不必等国家标准落定,先用现成工具跑一遍。目的是分层,不是考核。
- 第 2 个月
选 3 到 5 门课做 AI 改造试点,选 1 个专业做交叉课程包。宁可少,不可散。同步启动种子教师的作品制:结业不交学时,交作品。
- 第 3 个月
出一版实训室建设需求书,写清三个使用率;同步申报微专业,把教改成果往「智能教育」项目上靠。
结语工具三年一换,思想四十年没变
DeepSeek 在结语里写:
DeepSeek 原文我们并没有提出全新的理论,而是将计算机系统中经典的工程思想应用到了 Agent 系统的构建中。
这句话在技术圈是谦辞。放到教育里,是一句纲领。
因为过去两年,绝大多数高校的 AI 课程教的是工具:怎么用这个模型、怎么调这个参数、怎么点这个按钮。工具三年一换,等学生毕业,课上教的那一版已经下线了。
而文章里真正值钱的东西——分层、缓存、并发、容错、解耦、监控——是四十年没变过的思想。它们不在任何一款软件的说明书里,但它们决定了一个人能不能看懂复杂系统,能不能在工具换代时迁移自己的能力。
这就是「AI 课程改革」和「AI 工具培训」的分界线,也是这三件事必须同时做的原因。
没有一批愿意先冒险的人,课改推不动。
能力只能在真实的课程里长出来,长不在学时证明上。
思想需要一个地方被跑一遍,才变成能力。
三者同时动,一年见效。只动一个,三年归零。
这一轮 AI 进高校,最后卡住的大概率不是钱,也不是算力。文件已经把路径写清楚,钱也在一轮一轮往下走。
卡住的是人。没有人愿意在自己讲了二十年的课上,先冒一次险。
人的问题靠开会解决不了,靠发文件也解决不了。它只能在真实的课程里、真实的场景里,让一部分教师先跑通一遍,再让其他人看见「原来可以这样」。
不是再上三个项目,
是改一次结构。
延伸阅读与出处:① DeepSeek 产品部与 Harness 团队《Super-agent 设计探索:迈向更自主的 Agent 系统》(2026 年 10 月 31 日);② 教育部、国家发展改革委、工业和信息化部、科技部、国家数据局《「人工智能+教育」行动计划》(2026 年 4 月);③ 院校做法引自教育部官网、省级教育行政部门及公开报道(四川大学、合肥经济学院、哈尔滨职业技术大学、武汉大学、长江师范学院、山东外国语职业技术大学);④ 文中 12.4 分钟 / 29.5 分钟等实验数据为原文自陈的初步结果,仅作方向性参考。